AutoSuperMarket è nato su MariaDB per un motivo semplicissimo: era il database che conoscevamo meglio, e abbiamo iniziato con quello. Da allora sono passati anni, centinaia di tabelle e qualche milione di annunci. Il database delle statistiche era già su PostgreSQL dal 2024, il resto no.
Dal 20 settembre 2026, poco dopo l’una di notte, anche il database principale gira su PostgreSQL 18. Ci ho lavorato da solo per circa un mese e mezzo, dai primi test scritti a inizio agosto alla notte del cambio. Questo è il racconto di come è andata, di cosa si è rotto e di cosa ho imparato. È lungo, e pieno di SQL.
I numeri di partenza
- 165 GB di dati e 12,9 GB di indici in 265 tabelle, su tre nodi MariaDB 11.8: un master e due repliche.
- 3.597.655 righe nella tabella degli annunci, la più importante. Per settimane avevo ragionato su 2,2 milioni, perché quella era la copia di sviluppo: la produzione ne aveva la metà in più.
- Un’applicazione Symfony con Doctrine, 30 pod web su Kubernetes, feed di importazione da decine di gestionali, una console interna enorme.
- Al picco, 454 connessioni aperte contemporaneamente su MariaDB.
L’obiettivo era un cluster di tre macchine (8 vCPU, 32 GB di RAM, Debian 13) con PostgreSQL 18, Patroni per il failover, etcd, PgBouncer in transaction mode e haproxy dietro un indirizzo virtuale gestito da keepalived. PgBouncer non era facoltativo: 454 connessioni per MariaDB sono normali amministrazione, per PostgreSQL su otto core sono 454 processi.
Il rischio non era lo schema
La prima cosa che ho capito è che lo schema era la parte facile. Doctrine lo genera da solo per qualsiasi piattaforma, con poche correzioni: sei nomi di indice riusati su più tabelle (in MySQL sono unici per tabella, in PostgreSQL per schema), un tipo TINYINT da far ricadere su SMALLINT, e user ed end da quotare perché in PostgreSQL sono parole riservate.
Il rischio vero era il SQL scritto a mano: query native nei repository, DQL con funzioni MySQL, export, report, migrazioni. Roba che PHPStan non vede e che non dà errore finché qualcuno non apre la pagina giusta.
Così, prima di toccare una riga, ho scritto test. Test sui repository e uno smoke test che apre le pagine della console, per fissare i risultati attesi su MariaDB. Poi ho fatto girare la stessa suite anche su PostgreSQL, in un job di CI non bloccante che chiamavo “la sonda”.
La prima volta non è nemmeno partita. Poi i test falliti sono scesi così:
317 → 138 → 103 → 75 → 65 → 47 → 35 → 31 → 16 → 12 → 5 → 1 → 0.
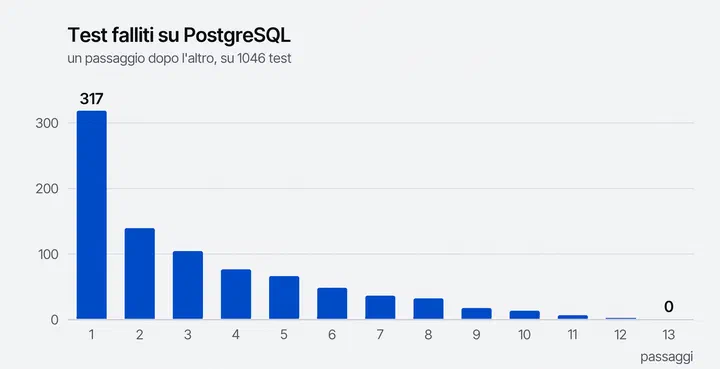
Alla fine tutti i 1046 test passavano su entrambi i motori. Oggi la suite gira solo su PostgreSQL ed è bloccante.
Un dettaglio imbarazzante: per una settimana il job di CI non ha misurato niente. Rendendo lo script lanciabile anche dal mio terminale avevo cambiato gli host di default, la pipeline puntava a una porta dove non c’era nessuno e si fermava prima di eseguire un solo test. Siccome il job poteva fallire senza bloccare niente, nessuno se n’è accorto, io compreso. Un job non bloccante che si rompe nel suo setup è indistinguibile da uno che è semplicemente ancora rosso.
Le cose che MySQL perdona
La maggior parte degli errori rientrava in poche famiglie.
I booleani. PostgreSQL ha un vero tipo booleano e non lo confronta con un intero. Ho letto i 183 campi booleani dai metadati di Doctrine e corretto 46 confronti con 0 e 1. Le aggregazioni su un predicato, comodissime in MySQL, in PostgreSQL non esistono:
-- solo MySQL
SUM(b.type = 'pro')
-- entrambi
SUM(CASE WHEN b.type = 'pro' THEN 1 ELSE 0 END)
Le funzioni. RAND, GROUP_CONCAT, DATE_FORMAT, JSON_CONTAINS, DATEDIFF, INTERVAL 3 DAY e compagnia sono diventate funzioni DQL che emettono SQL diverso per piattaforma. La traduzione di DATE_FORMAT in to_char solleva un’eccezione su un formato che non conosce, invece di formattare male in silenzio. Il caso che mi ha fatto più paura è %w, il giorno della settimana: MySQL conta la domenica come 0, to_char(..., 'D') come 1. Il centralino filtra le chiamate per giorno della settimana, e la traduzione ovvia avrebbe spostato ogni risultato di un giorno senza un solo errore.
Il GROUP BY. PostgreSQL applica sempre l’equivalente di ONLY_FULL_GROUP_BY. Il count delle ricerche veniva clonato dalla query principale e si portava dietro un CASE nascosto, usato solo per l’ordinamento (l’annuncio Pro+ in cima, le fasce di prezzo). Tolto l’ordinamento, il CASE restava nella select accanto al COUNT senza niente che lo raggruppasse. Questo è arrivato in produzione il giorno dopo il cambio, sulle pagine di ricerca degli annunci.
Il DISTINCT su un’entità con colonne json. In PostgreSQL json non ha un operatore di uguaglianza, quindi un DISTINCT su un’entità che ne contiene una fallisce. È saltato fuori un mese dopo il cambio, su quattordici pagine della console contemporaneamente: tutte quelle con una scelta del commerciale. L’ho risolto con un EXISTS correlato al posto della join, così nessuna riga si ripete e non c’è niente da deduplicare.
I numeri. Limiti come intval($x) * 0.95 venivano passati come float contro colonne intere. MySQL confronta numericamente, PostgreSQL rifiuta di leggere 104.5 come intero e butta via l’intera query. In un importatore di feed questo voleva dire 135 annunci importati su 210, senza un errore visibile.
Le divisioni intere. SUM(pay.price) / 100 in MySQL restituisce un decimale, in PostgreSQL fa una divisione intera: 4999 centesimi diventano 49 euro invece di 49,99. Nessun errore, solo un numero più piccolo in una dashboard dei ricavi. Sette query in tutto. Basta scrivere / 100.0.
Il secondo giro, leggendo il codice
Quando la sonda è diventata verde ho fatto l’errore di sentirmi tranquillo. Poi ho rifatto un giro leggendo il codice invece di eseguirlo: ogni stringa DQL, ogni SQL costruito a mano, ogni confronto con una colonna booleana. Ho trovato altri quattordici punti, nessuno coperto da un test.
Alcuni erano tutt’altro che oscuri. YEAR è il filtro per anno di immatricolazione della ricerca, YEAR_MONTH il raggruppamento mensile di ogni grafico della console: erano ancora registrati dalla libreria di estensioni MySQL.
La frase che mi sono scritto nelle note è questa: una sonda verde vuol dire che i percorsi coperti sono portabili, non che lo è il codice. Ogni test nuovo su un metodo mai testato trovava un’incompatibilità nuova. Il primo test sul metodo che sceglie gli annunci simili per i lead automatici ha trovato subito una query che PostgreSQL rifiuta, su un percorso che manda email ai clienti.
E una per l’autoironia: per un po’ ero convinto che PostgreSQL restituisse i booleani a PHP come stringa 'f', che in PHP è vera, e avevo immaginato scenari catastrofici. Poi l’ho misurato: con PHP 8.4 e DBAL 4 arriva un vero bool. Le correzioni sono rimaste, perché sono comunque la forma giusta, la catastrofe no. Misurare prima di raccontarsela.
I bug che c’erano già
La parte che mi ha divertito di più. La migrazione è servita più per quello che ha trovato che per quello che ha spostato: PostgreSQL rifiuta query che MariaDB eseguiva restituendo risposte senza senso.
La classifica dei commerciali era raggruppata per un booleano. Una query faceva SELECT ... AS seller ... GROUP BY seller. Ma la tabella degli operatori ha una colonna seller, il flag che indica se uno è un commerciale, e il GROUP BY risolve prima le colonne della FROM e poi gli alias. MariaDB rispondeva con tre righe per tutta l’azienda: commerciali, non commerciali e nessuno, ognuna con il nome del primo che capitava. PostgreSQL l’ha rifiutata.
Le distanze erano sbagliate. ST_Distance_Sphere legge la prima coordinata come longitudine, ma il punto era salvato come POINT(latitudine longitudine). Milano–Roma misurava 535 km invece di 477, con un errore che cresce sull’asse est-ovest. Siccome le distanze servono a ordinare città e concessionari vicini, era l’ordinamento a essere sbagliato. Nessun test se n’era accorto: tutte le coordinate delle fixture erano POINT(0,0). Oggi è una formula dell’haversine scritta per esteso, identica sui due motori.
Il filtro neopatentati non applicava mai il rapporto peso/potenza. Il Codice della Strada consente al primo anno al massimo 70 kW e 55 kW per tonnellata. Il codice calcolava potenza / peso * 100 con il peso in chili, cioè kW per quintale, e lo confrontava con 55: un limite di fatto di 550 kW/t, che nessuna auto in vendita sfiora. La versione DQL in più usava DIV, la divisione intera di MySQL, che portava a zero quasi ogni coppia. Adesso è una moltiplicazione incrociata, esatta sugli interi e uguale su entrambi i motori:
power * 1000 <= 55 * net_weight
Le notifiche delle ricerche salvate potevano partire a vuoto. L’hash dei risultati era SHA2(GROUP_CONCAT(listing.id), 256), ma l’ordinamento stava fuori dall’aggregato. Bastava un cambio di piano di esecuzione per cambiare l’hash e mandare una mail al cliente con gli stessi annunci di prima.
Gli annunci finivano sotto un modello a caso. Quando un feed lasciava vuoto il modello, la ricerca diventava LIKE '%%' con setMaxResults(1) e nessun ORDER BY. Un Ford Transit Connect veniva archiviato come Escort su MariaDB e come F-650 su PostgreSQL. Nessun ordinamento salva una query così, la rende solo stabilmente sbagliata.
Poi c’erano i “Top marchi” della pagina concessionario, raggruppati per id annuncio e quindi con un conteggio sempre uguale a 1; la cancellazione di una sede, che falliva su sei relazioni mai cancellate; e 1032 configurazioni portale su 1038 con una stringa vuota in una colonna json, che l’entità non riusciva a leggere già su MariaDB.
Maiuscole, minuscole e accenti
MySQL confronta il testo senza distinguere le maiuscole, PostgreSQL no. findByName('HYUNDAI') trovava Hyundai su uno e niente sull’altro. Non si risolve nelle query: ogni findOneBy su una colonna di testo ci conta.
Su PostgreSQL 16 la scelta obbligata era citext, perché le collation non deterministiche non supportavano LIKE, e io avevo una quarantina di query che lo usavano. Ma citext non ignora gli accenti, e un caso me l’ha fatto vedere bene: nei feed Serie 8 Gran Coupe senza accento finiva sotto Serie 8 invece che sotto Serie 8 Gran Coupé. In più citext non ha lunghezza, quindi perdevo i limiti dei varchar.
PostgreSQL 18 ha tolto quel limite, e il 20 settembre ho convertito 1117 colonne di testo a una collation ICU non deterministica che ignora maiuscole e accenti:
CREATE COLLATION case_accent_insensitive (
  provider = icu, locale = 'und-u-ks-level1', deterministic = false
);
Due lezioni imparate a caro prezzo, che vanno in direzioni opposte:
- Le due colonne di una foreign key devono avere la stessa collation, e PostgreSQL lo controlla al momento dell’
ALTER, non al commit. Quindi le chiavi vanno tolte e rimesse attorno a tutta la conversione, in una sola transazione. - La conversione delle lunghezze invece non deve stare in una sola transazione. Al primo tentativo ha preso un lock esclusivo su 198 tabelle e ha fatto deadlock con una normale query dell’applicazione. Una transazione per tabella, con un
lock_timeoutcorto e un secondo giro per quelle occupate, è la forma che funziona su un database vivo.
La ricerca di riserva
Il sito cerca gli annunci su Typesense; il database entra in gioco solo quando Typesense non risponde in tempo. Lì c’erano MATCH ... AGAINST e REGEXP, che in PostgreSQL non esistono.
La prima idea, pg_trgm, era sbagliata, e vale la pena dirlo perché è quella che viene in mente a tutti. Misurato sugli stessi 20.000 annunci, per bmw x4 xdrive:
| risultati | che contengono davvero “x4” | tempo | |
|---|---|---|---|
| pg_trgm (word similarity) | 84 | 15 | 160 ms |
tsvector + plainto_tsquery | 55 | 55 | 1,8 ms |
I trigrammi sbagliano in entrambe le direzioni: restituiscono roba irrilevante e perdono tre quarti di quello che dovrebbero trovare. Il full-text di PostgreSQL con un indice GIN fa esattamente quello che serve. Tra l’altro su MySQL la stessa ricerca di riserva con REGEXP impiegava 4,2 secondi, proprio sul percorso che si attiva perché la ricerca era già troppo lenta.
Postilla: un ramo aperto prima del port aveva aggiunto un suo REGEXP nella lista annunci del concessionario. È stato unito dopo che avevo tolto la registrazione della funzione, e il primo segnale è stato un errore fatale in produzione. Una funzione morta su master non è morta in tutti i rami aperti.
Copiare 165 GB
Per i dati ho usato pgloader, ma solo per i dati. Lo schema che genera da solo è pulito e sbagliato: per esempio trasforma i tinyint(1) in boolean, e la colonna pro degli annunci contiene 0, 1 e 2. I 457 annunci Pro+ sarebbero diventati Pro senza un errore. Così lo schema lo crea Doctrine, e pgloader lavora in modalità data only.
Cose che ho scoperto sulla mia pelle:
- Una riga ferma tutta la tabella. Date
0000-00-00nel bot assistente, date nell’anno zero arrivate da feed che avevano perso una cifra, stringhe vuote in colonne json. MySQL le aveva accettate, PostgreSQL no. Le ho pulite con una migrazione su MariaDB prima del caricamento. - pgloader ha un heap di 1 GB. Il primo caricamento a grandezza reale è morto dopo quattro minuti con
Heap exhausted, game over. Il file di configurazione aveva i parametri buoni per la copia di sviluppo, mentre le mie note dicevano già quelli giusti per la produzione. Vince sempre il file, perché è lui che gira. - pgloader non parla SCRAM. L’ho fatto girare sul nodo primario, attraverso il socket locale con autenticazione peer.
- Un indice btree ha un limite di 2704 byte per riga. Il mapping dichiarava un indice “fulltext” che su PostgreSQL diventa un btree normale, su descrizioni lunghissime. Una sola riga troppo lunga ha fatto annullare il caricamento di tutti i 3,6 milioni di annunci, mentre tutto il resto era andato liscio.
Il caricamento di tutto tranne gli annunci ha richiesto 1 ora e 19 minuti, per 126 milioni di righe; poi gli annunci, da soli. Per avere una fotografia coerente ho fermato una delle repliche MariaDB su un GTID preciso, e da quel punto è ripartito Debezium.
Alla verifica, tabella per tabella, il conteggio era identico su 262 tabelle, a parte le righe orfane cancellate di proposito. Ne sono saltate fuori 16.191, in undici tabelle, tutte riferite ad annunci che non esistevano più. Qualche ora prima le avevo cercate su una lista di vincoli che mi ero scritto, e avevo trovato zero. Rimettendo le foreign key per davvero sono comparse. Bisogna testare i vincoli, non una lista di vincoli.
Debezium e il binlog
Tra il caricamento e il cambio, le scritture su MariaDB dovevano arrivare anche a PostgreSQL. Ho usato Debezium con il connettore MariaDB e il JDBC sink, dopo aver portato il master a binlog_format = ROW.
Funziona, ma ha un po’ di mine:
- I timestamp si spostano in silenzio in base al fuso del worker Connect. Un
TIMESTAMPdelle 23:30 arrivava come l'1:30 del giorno dopo. Nello schema c’erano soloDATETIME, quindi mi è andata bene. - Lo stato del connettore mente. Dopo un errore il connettore dice
RUNNINGmentre il task èFAILED. - Un messaggio avvelenato non si toglie da solo, e
errors.tolerance=allnon aiuta. L’unico modo che ho trovato è ricreare il sink con un altro nome. - Gli UUID in
binary(16)richiedonobinary.handling.mode=hexsulla sorgente e?stringtype=unspecifiedsull’URL JDBC del sink. Una delle due da sola non basta. - Il sink scrive con
session_replication_role = replica, che disattiva anche le foreign key. Così alcune cancellazioni non applicate hanno lasciato 51 righe orfane senza che nessuno protestasse, finché non ho rimesso i vincoli.
La notte
Ero a casa da solo. Il 20 settembre a mezzanotte e 48 ho messo MariaDB in sola lettura con SET GLOBAL read_only = ON, aspettato che il sink smaltisse la coda, messo in pausa i connettori, portato le sequenze oltre gli id replicati e fatto il deploy con la configurazione che punta a PostgreSQL.
La durata della finestra l’ha decisa il rolling update. Ogni pod ancora con la vecchia configurazione continuava a scrivere su un MariaDB in sola lettura, e gli errori si sono fermati all'1:01, quando è ripartito l’ultimo dei 30 pod web. Dodici minuti e mezzo di scritture rifiutate, tutti dovuti al rollout.
Subito dopo: 112.353 commit in 45 secondi su PostgreSQL, nessun errore di PostgreSQL in Sentry, MariaDB con due connessioni addormentate. Sono andato a letto.
Il giorno dopo
Ovviamente non è finita lì.
Verso le due di notte è arrivata una raffica di server closed the connection unexpectedly, in punti del codice che non c’entravano niente tra loro. Quando falliscono insieme un template Twig, un feed e tre repository, non è il codice: è il pool sotto che sparisce. L’health check di haproxy toglieva una replica dal pool di lettura quando restava indietro di più di 16 MB, cioè un solo segmento di WAL, e un autovacuum della tabella annunci ne scrive 3 GB. In più sul pool delle repliche c’era on-marked-down shutdown-sessions, che chiudeva le letture in corso. Ha senso sul primario, dove una sessione su un nodo appena declassato scriverebbe su un server in sola lettura; su una replica, una lettura un po’ vecchia è comunque corretta. Soglia a 256 MB e opzione tolta. Errori miei, tutti e due.
Nei giorni successivi sono arrivati gli ultimi casi, uno alla volta: il count della ricerca con il CASE nascosto, e la lista dei concessionari insolventi che confrontava una colonna timestamp con dei letterali dentro un CASE. PostgreSQL li tipizza come text prima ancora di guardare il confronto, MySQL li convertiva in silenzio.
Sulle prestazioni, la sorpresa è stata non avere sorprese. Sulle quindici rotte più trafficate, a tredici ore dal cambio, la mediana pesata sul traffico è passata da 172 a 184 ms, mentre il p99 è sceso del 14%. L’istogramma dei prezzi della ricerca ha più che dimezzato il suo p99, da 22,2 a 9,9 secondi. Quella mattina però il traffico era molto sopra la media, e la home, che passa il 91% del tempo a renderizzare Twig e il 4% in SQL, era peggiorata quanto le altre: buona parte di quei 12 ms viene dal carico, non dal database. PostgreSQL si comporta da motore più prevedibile, e forse un filo più lento.
Cosa mi porto a casa
- Scrivere i test prima, sul motore vecchio. Senza, la migrazione mi avrebbe fatto scoprire questi problemi in produzione, con grafici sbagliati o pagine in errore.
- Una suite verde dice cosa hai coperto, non cosa funziona. I problemi successivi li trovi allargando la copertura, non leggendo i messaggi di errore.
- Gli errori silenziosi valgono più di quelli rumorosi. Una query rifiutata la vedi subito. Una divisione intera, un giorno della settimana spostato di uno o una distanza con le coordinate invertite no.
- Misurare, non supporre. Le due volte che ho dato per scontata una causa (un problema di accenti, un feed corrotto) mi sbagliavo, e la risposta è arrivata importando lo stesso feed sui due motori e confrontando i risultati.
- Tenere le note mentre si lavora. Ho aggiornato un documento di migrazione a ogni scoperta, e più di una volta ha dovuto correggere sé stesso. Un documento con una diagnosi sbagliata è peggio di nessun documento.
MariaDB ora è in sola lettura, fuori dal percorso. PostgreSQL regge, e a quanto pare anche io.